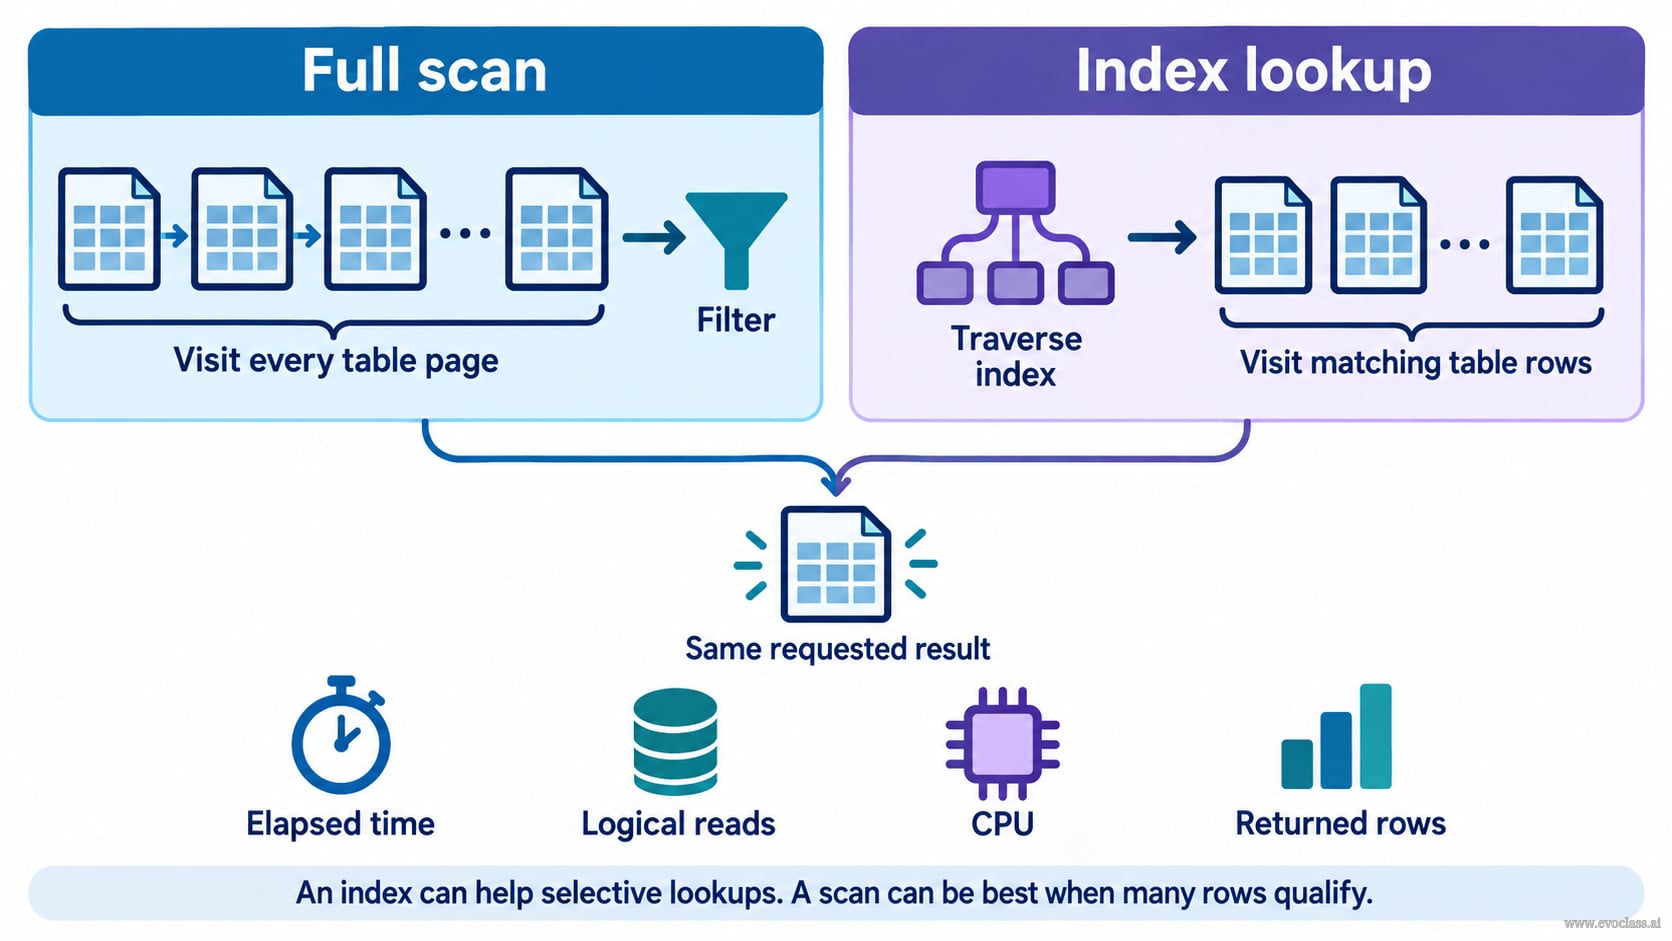
데이터베이스 관리에서 올바른 논리적 결과를 얻는 것은 목표의 절반에 불과하며, 쿼리 성능 을 이해해야 데이터베이스가 시스템 리소스를 낭비하지 않고 효율적으로 결과를 계산할 수 있습니다. 쿼리는 요청한 데이터를 정확히 반환하면서도 내부적으로 비효율적으로 실행될 수 있습니다.
학습 목표 및 배경
강의 11 — 옳은 답, 형편없는 쿼리: 동작하는 SQL을 작성하는 것만으로는 충분하지 않음을 강조합니다. 데이터베이스 개발자는 쿼리 최적화 프로그램이 내부적으로 어떻게 연산을 실행하는지 이해해야 합니다.
핵심 개념
- 논리적 정확성 vs. 실행 성능: 데이터를 성공적으로 반환한다고 해서 효율적인 리소스 활용이 보장되지는 않습니다. 기능적으로 동일한 두 쿼리가 완전히 동일한 출력 테이블을 생성하면서도 CPU, 메모리, 디스크 I/O를 크게 다르게 소비할 수 있습니다.
- 시스템 확장성에 미치는 영향: 비최적화 쿼리는 성능 병목 현상으로 작용하여 동시 사용자 속도를 늦추고, 서버 부하를 증가시키며, 데이터베이스 크기가 커짐에 따라 원활한 확장이 어려워집니다.
- 예시 시나리오: 수백만 행이 있는 테이블에서 특정 고객을 검색하는 경우입니다. 비효율적인 쿼리는 수초가 걸리는 전체 스캔을 강제하는 반면, 최적화된 쿼리는 수밀리초 만에 레코드를 검색합니다.
보충 노트
강의 11 — 옳은 답, 형편없는 쿼리: 데이터베이스 개발자는 쿼리가 과중한 운영 환경 워크로드에서 효율적으로 확장되도록 실행 계획을 분석해야 합니다.